系统上线之后的第一批数据,谁来把关
一、首批数据为什么格外要紧
系统上线,最怕的不是功能没配好,而是第一批数据就带着病进来。基础资料是从各处收拢来的旧账本,来源五花八门,写法各异。里面混着重名、漏项和过时的信息。这批东西一旦进了系统,就成了所有报表、提醒和分析的地基,地基歪了,后面盖什么都是斜的。
首批数据的特殊性还在于它的示范效应。团队会盯着最初的报表形成对系统的第一印象:如果头一批跑出来的数字就漏洞百出,大家对系统的信任会立刻打折,往后录入也更随意,形成恶性循环。反过来,第一批数据干净,报表立得住。团队才愿意认真对待。
很多企业事后回头清理数据,花的心思比当初录入多得多。因为脏数据不是静止的,它会被引用、被关联、被汇总进各种报表。牵一发而动全身。等到用的时候才发现问题,清理起来要沿着所有关联一路捋过去。代价远高于入口处就把好关。
所以说,首批数据是把关成本最低、收益最高的一个关口,这道关守住了,后面的事事半功倍:
- ● 报表一开始就有可信度,管理层敢拿来做判断;
- ● 团队看到数据被认真对待,录入习惯也跟着认真;
- ● 避免日后大规模返工,省下高昂的清理代价;
- ● 后续的自动化规则建立在干净数据上,跑得顺畅。
还可以换个角度看:首批数据是团队和系统的初次见面。这批数据怎么收上来的,反映的是企业做事的认真程度;这批数据后来怎么被使用,又决定了团队接下来怎么对待它。起点上的质量,会一路传导下去,起点马虎。后面处处要还账。
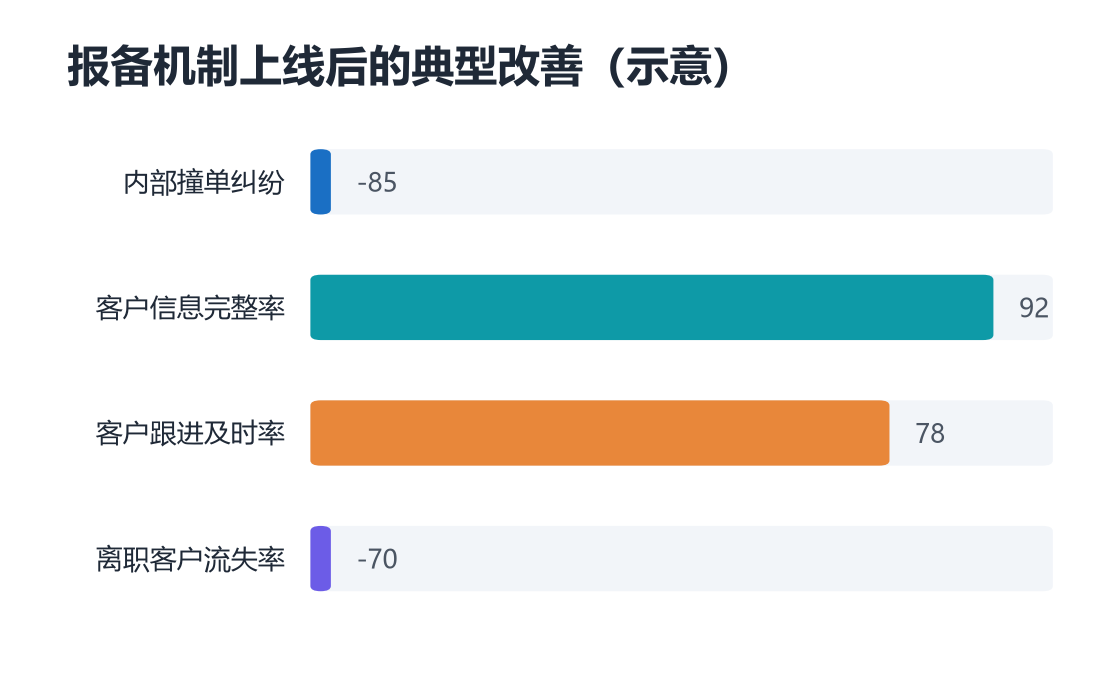
图1:机制跑顺之后,跟进状态明显改善
二、数据从哪里来,搬运的路上就有多少种出错方式
上线之前的数据迁移,表面看是搬运,其实是翻译:旧表格里的客户名、联系人、阶段备注,要翻译成新系统里的字段和格式。每翻译一步,都可能走样。讲真,名称多一个空格,阶段对不上新流程,联系方式缺了区号,单看都是小事。攒在一起就是一片雷区。
出错的方式还不止翻译这一种。旧数据里有的是多年前的老底子,客户早就换了联系人,地址早已作废;有的表格被好几个人改过,同一栏里出现好几种写法;还有的信息当时就填得随意,备注栏里塞着半句话,谁也不知道什么意思。搬运的人照单全收,旧毛病原样带进新家。
更隐蔽的问题是遗漏。旧表格往往缺列少项,搬的时候没人补齐。进了系统就成了永远空着的字段。这些空字段平时看不出影响,等报表按这些维度统计时才发现。一整块分析做不了,只能回头补录。
梳理下来,搬运路上常见的坑有这些:
- ● 旧表写法不一,直接搬入后口径依旧混乱;
- ● 过时信息无人核实,作废的联系人照搬进来;
- ● 缺项漏项没人补,关键字段长期空着;
- ● 重复档案没有事先合并,重名记录成对出现;
- ● 新旧流程字段对不上,搬运时凭理解硬套;
- ● 特殊情况随手塞进备注,语义全靠猜。
三、把关这件事,不能指望人人自觉
数据质量出了问题,最常见的反应是开会强调:大家录入认真一点。这话说了等于没说。录入的人有自己的工作节奏,手头的单子催得紧,填资料自然是能省则省;而且没有具体标准时,认真不认真全凭各自理解,十个人有十种认真法。
自觉靠不住,是因为责任没落到人头。数据出了错,追究起来人人有份又人人无责:录入的说是源头给的,源头说没人告诉他规则,管理层最后不了了之。没有明确的责任人,把关就成了一句口号,喊的时候响亮。做的时候没人认领。
有人把把关理解成挑错,其实把关更是预防。挑错是数据进来之后的事,成本高还伤感情;预防是在入口处就把坑填平,规则写清楚、示例给明白、校验卡到位,错误没机会发生,也就不存在追责的尴尬。把功夫花在预防上,把关这件事才不招人烦。
还有一个现实原因:数据质量是慢变量,好坏不会立刻兑现成业绩。说白了,录入马虎,当月的订单照签,谁也看不出影响;等报表失真、提醒失效的时候,早忘了当初是谁随手填错。代价滞后,责任就更难挂钩。
所以指望人人自觉,不如把把关设计成一套明确的安排:
- ● 每类数据指定专门的责任人,出了问题找得到人;
- ● 录入规则写成看得懂的短清单,贴在录入入口;
- ● 关键字段设必填和校验,缺了、错了过不去;
- ● 定期抽查通报,让数据质量被持续看见;
- ● 抽查里冒出来的好做法,及时拿出来推广。
四、责任落到人头,校验跟着流程走
把关的落点,是让每个环节都有明确的责任人。数据从旧表格里出来,先由整理的人负责初步清洗;进系统时,录入的人对格式和完整性负责;审核的人对照清单验收,确认无误才转正。三层各管一段,谁手上的环节出问题,责任清清楚楚。
落到工具上,海软CRM给首批数据留了专门的校验入口:必填项卡住空值,重复的名称建档时就提示,格式不对的字段当场标红。很多低级错误根本走不到审核那一步,在录入的当下就被拦了下来。把关的负担轻了一大截。
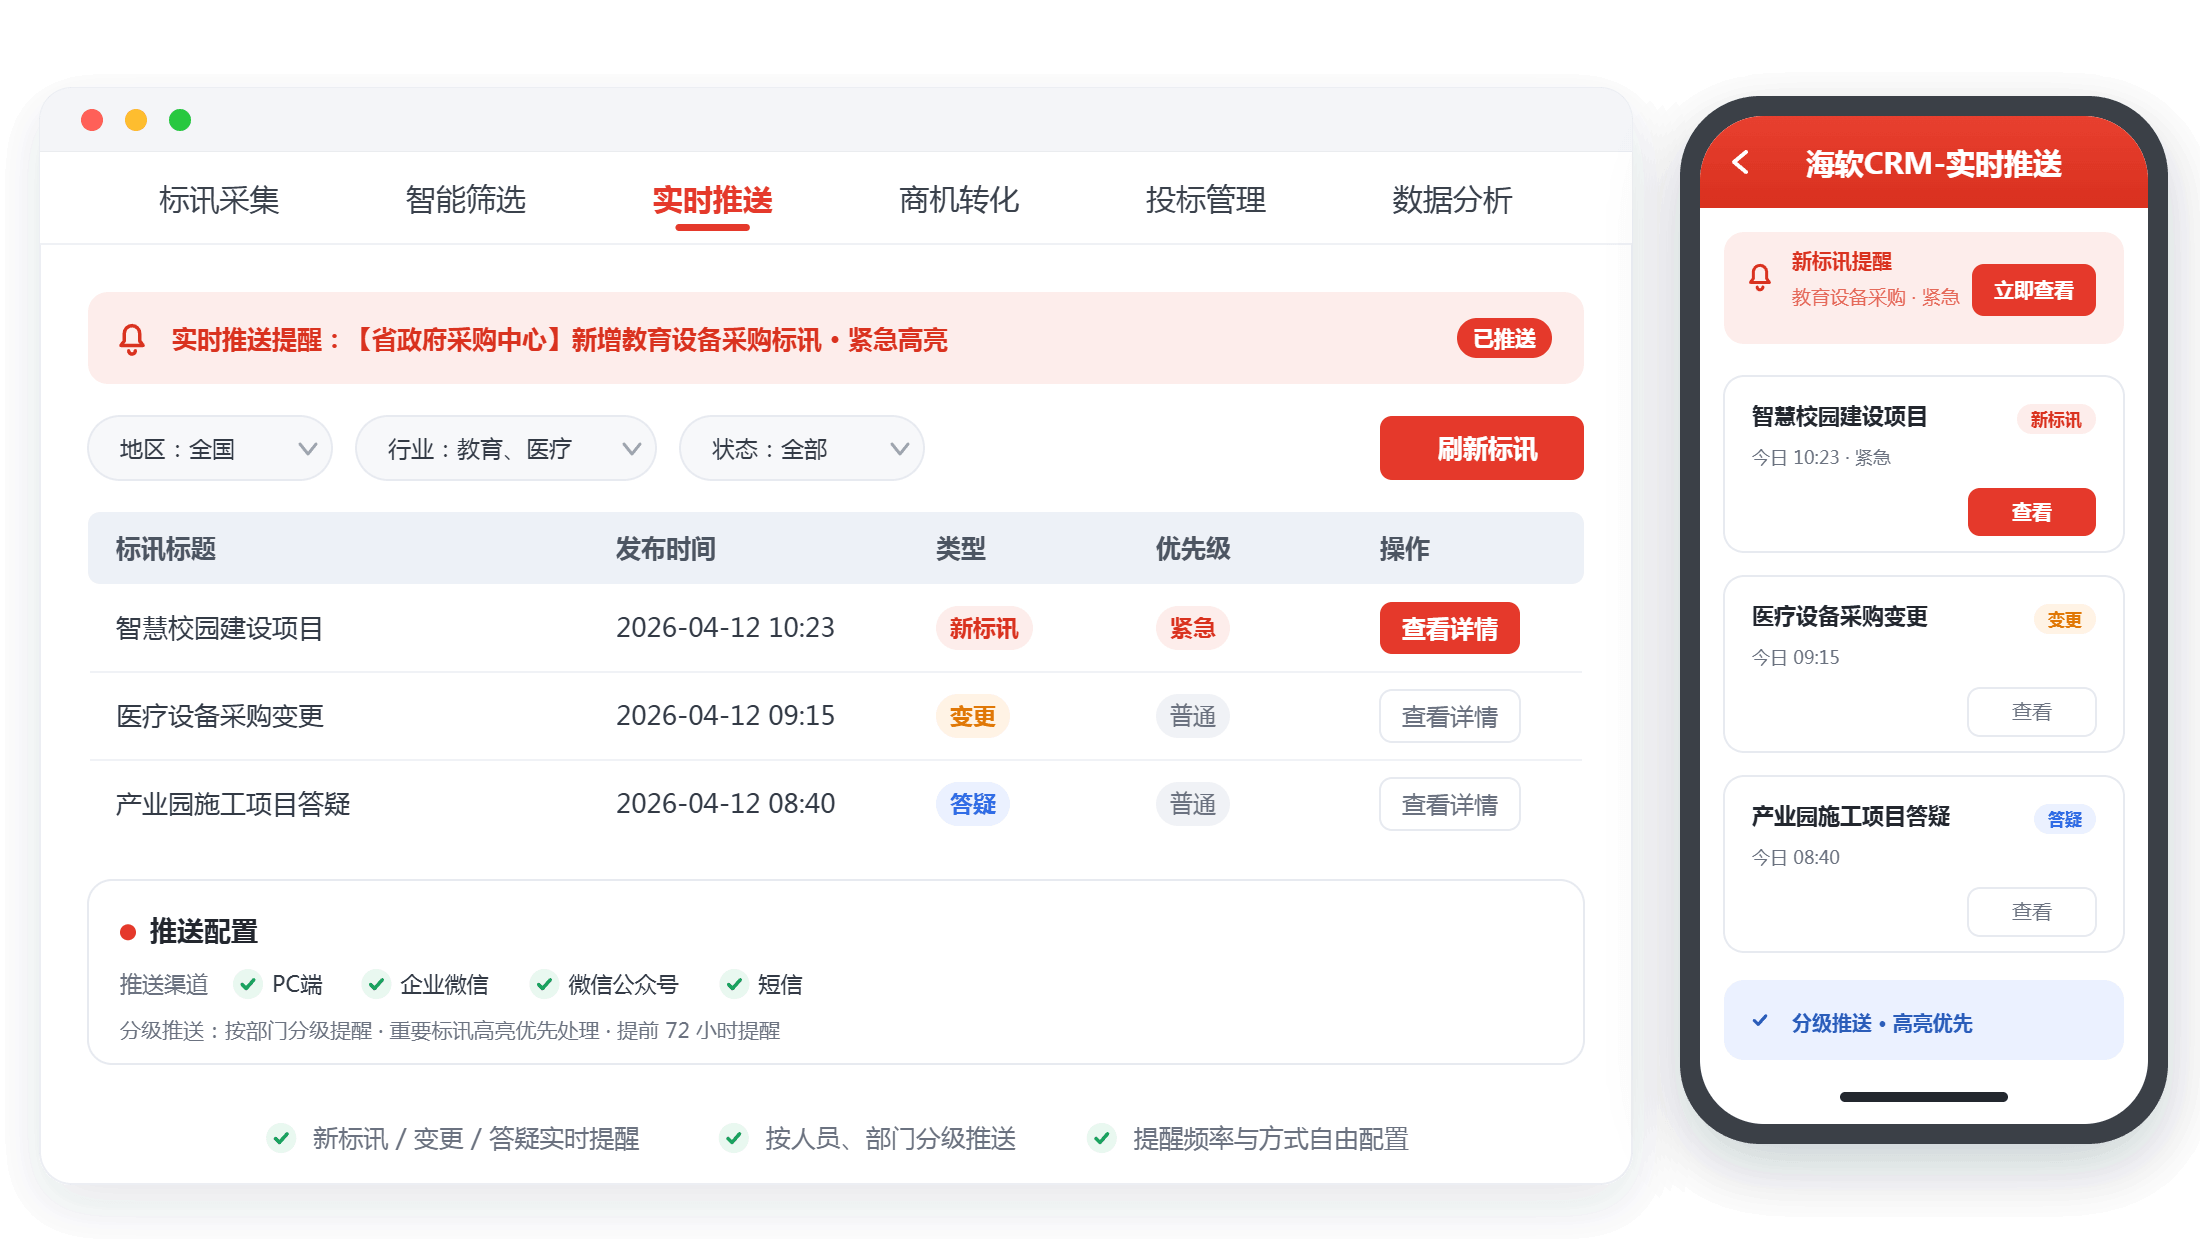
图2:重要动态实时推给该跟进的人
责任人之外,还要给把关配上节奏。上线初期宜加密抽查,隔几天看一批新录的数据,发现问题立刻纠正。把习惯在建档高峰期就掰正。等数据稳定了,抽查的间隔可以放宽,但不要停,因为人的松懈是无声的,不盯就会回潮。
有一家做工业配件的企业上线时专门指定了数据把关人,头一段时间每天抽看新档案。发现问题当天反馈给录入的人。起初大家觉得繁琐,很快发现报表里的客户统计头一回对得上数,管理层在会上照着系统直接讨论,不再需要各处核对,把关这件事反而成了大家愿意维护的东西。
五、首批数据立住了,后面才谈得上经营分析
第一批数据守干净了,系统的种种能力才有了用武之地。报表按客户统计能对上数,跟进提醒推出去的是真实有效的线索,管理层看到的商机分布反映的是实情。数据可信,分析才有意义,这是绕不开的先后顺序。
反过来,首批数据失守的企业,往往要经历一段痛苦的还账期:停下手头的事,组织人力清洗旧档,合并重复,补齐缺项,期间报表不敢用,判断还得靠老办法。简单说,这段弯路完全可以避免,只要上线时多花点功夫把好入口关。
再往远处看,首批数据的质量还影响后面每一次扩展。以后想加自动化规则、想做客户分层。前提都是基础数据靠得住。地基打得好,往上加盖都容易;地基虚了,每加一层都要先返工,谁也不愿意接手这样的摊子。
把关这件事说到底,考验的不是技术,是管理的认真程度。肯在数据入口处花心思的企业,后面每一步都省力;入口马虎的企业,代价只是推迟了,并没有消失,而且拖着利息。数据是系统的粮食,粮食的质量决定系统的成色。
所以别把首批数据当成上线流程里顺手做掉的杂事,把它当成一项正经的验收工作来对待:有人负责、有清单可依、有抽查兜底。这道关守好了,系统才算真正落地,往后的每张报表、每次复盘才有底气。
六、常见问题集中答
1、问:系统上线后的第一批数据,为什么格外重要?
答:因为它是所有报表和分析的地基,而且有示范效应。第一批数据干净,跑出来的数字可信,团队才愿意认真录入。第一批数据带着重名、漏项进来,报表失真,信任打折,后面每一步分析都建立在歪地基上,清理的代价远高于入口把关。
2、问:数据迁移时最容易出哪些问题?
答:常见的是写法不一照搬进来、过时的联系信息无人核实、关键字段缺项没人补、重复档案没有事先合并,以及特殊情况随手塞进备注。这些毛病单个都不起眼,攒在一起就会让报表失真,所以迁移前要安排专人做一轮清洗和核对。
3、问:数据把关的责任应该怎么分配?
答:按环节分。整理的人对源头清洗负责,录入的人对格式和完整性负责,审核的人对照清单验收后数据才转正。每类数据指定明确的责任人,出了问题找得到人,而不是人人有份又人人无责。责任落到人头,把关才不会停留在口号上。
4、问:靠开会强调认真录入,为什么不管用?
答:因为没有具体标准和责任挂钩。录入的人手头工作紧,能省则省,认真与否全凭各自理解;数据质量又是慢变量,马虎的代价要等报表失真才显现,追责时早忘了当初谁填错。有效的是把校验做进流程,必填卡住空值,重名当场提示。
5、问:上线之后,数据质量要盯到什么程度?
答:上线初期加密抽查,隔几天看一批新录的数据,发现问题当天反馈,把习惯在建档高峰期掰正。数据稳定后可以放宽间隔,但不要停,人的松懈是无声的,不盯就会回潮。把抽查结果放进例会过一眼,让数据质量被持续看见。