业务想看个数据还要排队等排期?报表就该让业务自己动手来拉
告别提需求等排期,让业务人员自己动手拉CRM报表的时代到了
一、报表的需求为什么总在排队
业务想看一个数,先要提需求,再等排期,最后拿到一张不一定对口味的表。整个过程里最消耗耐心的不是等待,而是等到之后发现口径不对,还要再走一轮。
排队的根本原因,是拉数据这件事被交到了少数人手里。会写查询、会配视图的人不多,需求却来自各个业务口,供给和需求天然对不上,于是只能排队。
更深一层的问题是,排队的成本不只是时间。业务人员在等待期间往往凭印象先做判断,等报表出来时结论已经用出去了,报表反而成了事后补充。起不到支撑决策的作用。
还有一个不那么明显的原因:需求提上去之后,往往要经过一轮确认。提问的人说不清想要的维度,接需求的人按自己的理解去做,来回两三次之后。时间就过去了大半。
要减少排队,思路不是让人做得更快,而是让不需要排队的那部分需求不再进入队列。日常的、口径固定的查看,交给业务自己完成;真正复杂的一次性分析,再集中交给专人。这样分工之后,队列会短很多。
排队还有一个不易察觉的副作用:它会让问题本身发生变形。为了适应排期的节奏,业务人员会倾向于提那些容易做出来的需求,而不是最需要回答的问题。时间一长,系统里沉淀的分析越来越偏向容易实现的方向。与业务的真实关注点渐行渐远。
- ● 排队的原因是拉数据被少数人垄断
- ● 等待期间凭印象决策,报表就成了事后补充
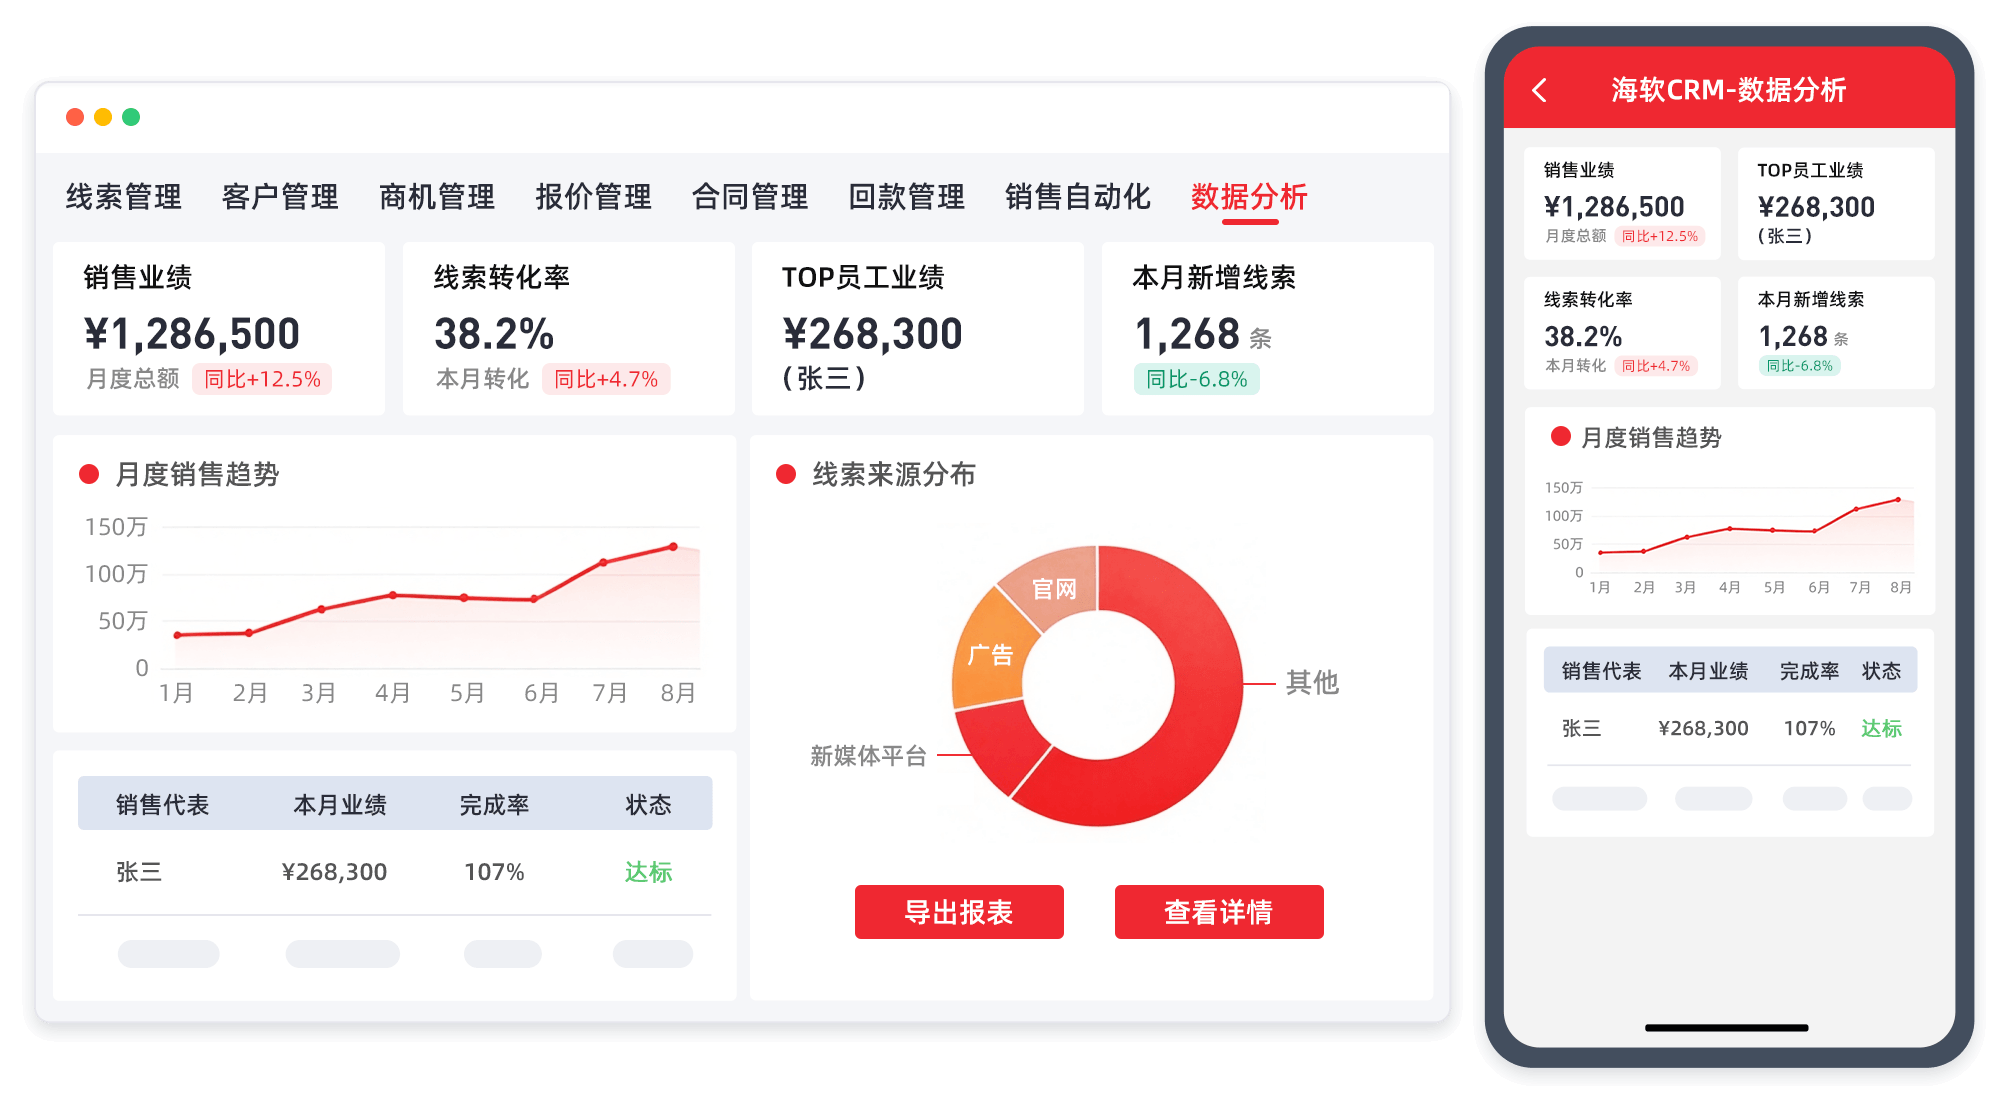
图1:数据摆在那里,得有人能拉得出来
二、自己拉数和提需求,差别在哪
让业务人员自己拉数,和让业务人员提需求,看起来只是分工不同。实际差别很大。
提需求的模式里,业务要先把想问的问题翻译成技术语言。这个过程本身就会损失信息。摊开讲,翻译得不准,拿回来的报表就偏了方向,反复几轮之后。双方都疲惫。
自己拉数的模式里,业务可以直接按自己关心的维度去组合,试错成本低。看到不对就换一个角度看。这种方式还有一个附带效果:业务人员在动手的过程中会更清楚自己的数据长什么样,提出的问题也会更具体。
要做到这一点,前提是报表工具足够简单。判断简单的标准很朴素:一个只用过表格软件的人,看一遍演示之后能不能自己拉出第一张。
自己拉数还有一个不太被注意的好处:它让业务人员对数据的质量变得敏感。亲手拉过几次之后,哪些字段经常空着、哪些记录明显不规范,他们比谁都清楚,也就更有动力去把源头录好。
当然,自己拉数不等于各做各的。前提是有一批公共的维度定义放在那里,大家在同一个基础上组合,否则灵活就会变成各说各话。
自己拉数还有一个常被忽略的条件:数据本身要足够干净。如果必填字段长期空着,拉出来的结果就会一片空白,业务人员试两次之后就会退回原来的做法。所以这一项能力和第一层记录的质量是互相牵制的。
这也说明六项能力之间存在先后:记录不扎实的时候,报表这一项即使上了也很难用出效果。
先把记录做扎实,再谈让业务自己拉数。顺序反了往往白费力气。
- ● 提需求要经过翻译,信息在这个过程中会走样
- ● 判断工具是否简单,看业务人员演示一遍后能不能自己上手
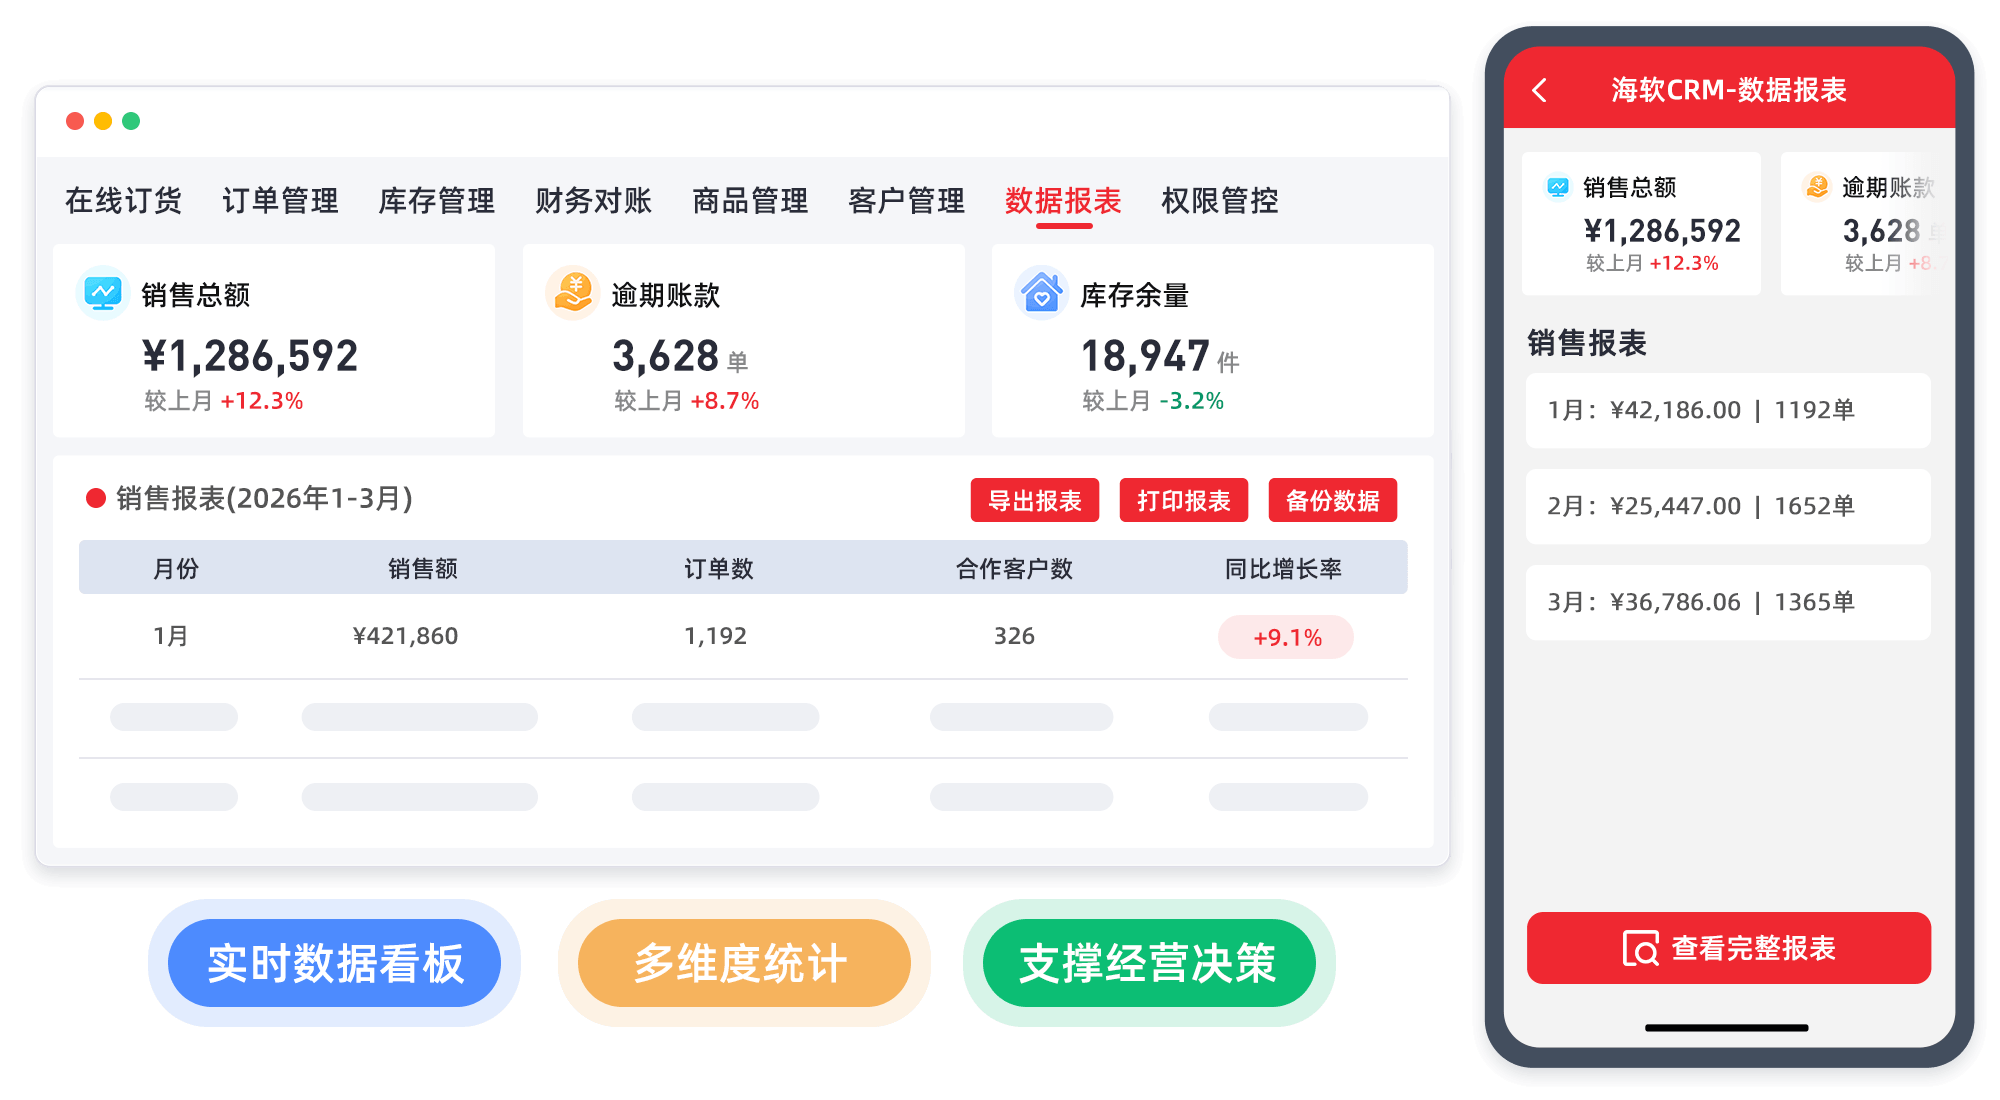
图2:业务自己出的报表,通常最贴近实际
三、口径统一比报表好看重要
自己拉数带来一个副作用:每个人拉出来的口径可能不一样,同一件事出现两个数。
解决这个问题不是把权限收回去,而是把口径沉淀下来。常用的口径做成公共视图或者公共指标,业务人员在此基础上做自己的组合。既保留了灵活,也避免了各说各话。
口径这件事还牵扯到信任。一旦出现两个版本的数,团队会开始怀疑所有数据,最后又回到凭经验判断。所以宁可少做几张漂亮的报表,也要先把关键口径统一。
口径的沉淀还需要有人负责。讲真,谁定义、谁维护、多久复核一次。这些都要有明确安排。没有负责人的口径,过一段时间就会和实际业务脱节。变成一套只在报表里成立的说法。
复核的节奏可以跟着业务变化走。业务规则调整之后,对应的口径要跟着过一遍,不能等到两个数对不上才回头查。
公共口径的数量不必多。把最常用的十几项定下来,就能覆盖大多数日常查看。定得太多,维护跟不上,反而会出现几项口径互相矛盾的情况。
- ● 口径沉淀成公共视图,兼顾灵活与一致
- ● 出现两个版本的数,团队会怀疑所有数据
图3:报表能不能自己拉,决定决策的快慢
四、报表怎么用才不浪费
报表做出来没人看,是很常见的浪费。避免浪费的关键,是把报表和使用场景绑在一起。
比较有效的做法是先定场景,再定报表。比如周会要判断哪一批机会需要支援,那就配一张按阶段和停留时长排列的清单;月度复盘要看去向,就配一张按来源与转化的视图。每一张报表都对应一个明确的动作,没有动作的报表就不要做。
另一个做法是把报表嵌进日常界面。管理者打开首页就能看到关心的那几项,不必专门去找报表入口。看的地方离得越近,被使用的概率越高。
报表的命名也要花点心思。名字写清楚口径和使用场景,比如按来源看新增情况,就比笼统地叫客户分析表有用得多。名字本身就是说明书,能省掉很多解释。
另一个细节是留出对照的口径。单看一个数很难判断好坏,能同时看到前一段的情况。判断立刻就有了依据。
还有一个前提容易被漏掉:报表要有明确的负责人。谁负责这张报表的口径、谁负责在业务变化之后更新它,如果没有安排,报表就会慢慢变成一张没人维护的旧图。
- ● 先定使用场景,再定报表内容
- ● 报表嵌进日常界面,被使用的概率更高
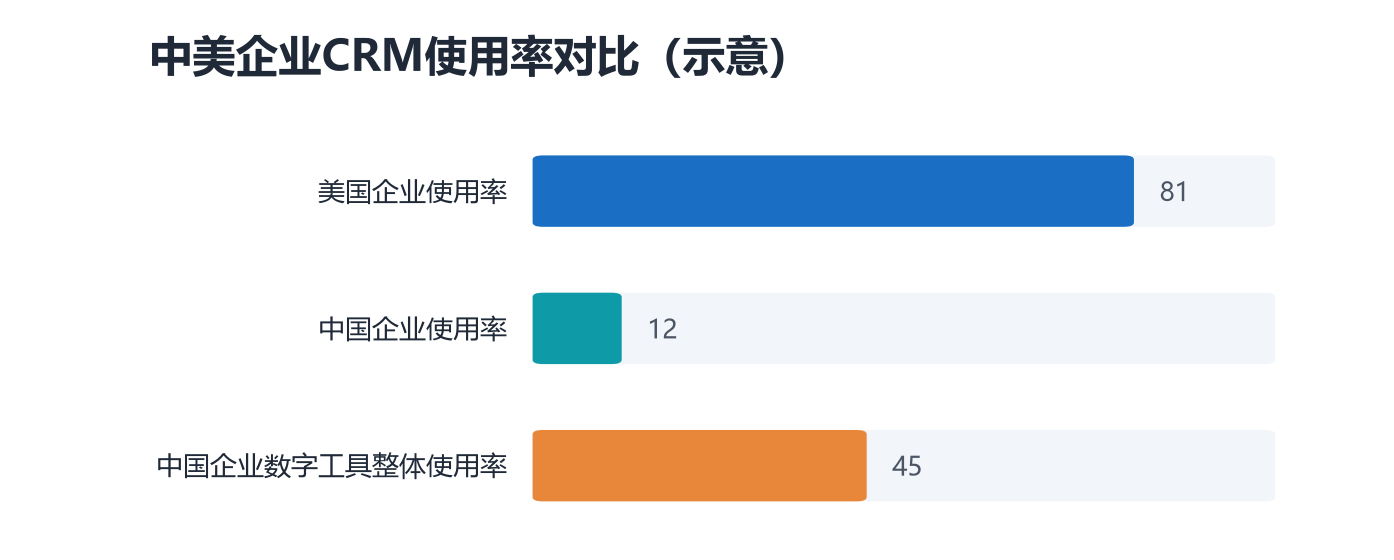
图4:用得多不多,是检验好用与否的尺子
五、怎么验报表能力
验证报表能力,有三个具体动作。
第一个是现场出题。拿一个业务上真实关心的问题,让厂商当场拉出对应的视图。重点不看结果好不好看,而看从提出到出结果用了多少步、有没有借助开发。
问口径怎么维护。平心而论,公共口径由谁定义、调整一次需要多久、历史数据会不会跟着变。这几个问题能问出这套报表体系是真正在运营,还是只在演示时存在。
看数据边界。报表能不能按角色限制可见范围,业务人员拉出来的数会不会超出自己该看的部分。这一条在多层级组织里尤其重要。
海软CRM把自定义报表放到了业务侧,业务人员用低代码的方式组合字段与条件就能出结果,常用的口径可以先沉成公共视图,让不同的人在同一套定义上做各自的组合。对希望缩短决策链条的团队来说,这种安排能省掉相当一部分沟通成本。
还有一个可以顺手确认的点:拉出来的视图能不能导出,导出的格式是不是常用的。这些决定了这份数据能不能在系统之外继续被使用。
还有一个容易漏掉的确认点:业务人员能看到的范围,是不是与自己的职责相符。范围过宽会带来顾虑,范围过窄又会让判断缺少依据。
这几项都确认过之后,报表这一层的判断基本就能落下来了。
- ● 现场出题,看从提问到出结果用了几步
- ● 问清口径由谁维护、历史数据会不会变
- ● 报表可见范围要能按角色限制
六、这几个问题问得最多
1、问:业务人员自己拉数,会不会造成口径混乱?
答:会有这个风险,所以要先做一层公共口径。常用的定义固定下来,自由组合只发生在个人关心的维度上,混乱基本可以避免。
2、问:报表数量是不是越多越好?
答:不是。报表的价值取决于它是否对应一个具体动作。没有动作对应的报表,做出来也只是占位置。
3、问:历史数据会不会因为口径调整而变化?
答:取决于系统的处理方式。有的方案会重算历史,有的只对新数据生效。这两者在复盘时得出的结论完全不同,选型时要问清楚。
4、问:管理者需要的报表和一线需要的一样吗?
答:不一样。管理者关心整体进度和异常,一线关心自己手上那几条。分开配置,各自看到的都是有用的内容。
5、问:报表能不能直接在手机上查看?
答:能查看是基本要求。更进一步的是能不能在手机上做筛选和切换维度,这决定了一线在客户现场能不能用得上。