销售预测总对不上,真是填报态度问题吗?CRM里三处漏洞才是根子
预测失真别再怪填报态度,CRM里三处结构性漏洞才是真正的根源
一、失真的来源不止一处
要区分这三处,可以用一个方法:假设所有填报人的态度都变得非常认真,看看误差会不会消失。如果会消失,那问题出在态度;如果不会,说明误差来自结构。按这个假设检验一遍,绝大部分误差都会落在结构这一侧,这意味着光靠强调纪律解决不了。
谈到预测不准,很多人的第一反应是「填的人不认真」。把责任推给态度,问题就永远解决不了。
真实的失真其实来自三处不同的地方。它们的成因、表现和治法是三回事。混在一起谈,只会得出一个笼统的结论:数据不可靠。分开来看,每一处都有明确的着力点。
- ● 一处出在记录方式,同一份需求被记了多次
- ● 一处出在口径,同一个东西被叫成了两个名字
- ● 一处出在立场,填报时自己先加了一层保险
这三处的共同点是它们都不表现在数字本身上。拿一份汇总表来看,几百个数字摆在那里,哪一个是被重复计入的、哪一个是因为叫法不同被拆散的。表面上完全看不出来。要发现它们,只能从记录之间的关系入手,而不是从数字的大小入手。
图1:看不见的偏差,最需要可核对的痕迹
二、第一处:同一份需求被反复计入
查重的难点在于判断「什么算同一个」。同一个客户名称下可能挂着两个不同的采购主体,同一个项目在两条线上可能有不同的叫法。所以查重不能只比名称,还要看型号、区域、时间这一组信息。把几项合起来判断才靠谱。
第一处失真最普遍,也最容易被忽略。
半导体生意的终端数量有限,同一个客户往往同时和厂商、和几家分销环节都有往来。实话讲,客户在本地采购一批,又通过原厂通道谈了一个项目,如果两条路径各自独立地记了一次,汇总起来看。需求量就变成了两份。
这种重复不是谁故意造成的,而是信息不互通的自然结果。分销环节不知道原厂那边已经登记了这个客户的项目,原厂也不清楚本地已经有了采购记录。除非系统里能互相看到,否则这种重复会一轮一轮地发生。
- ● 同一个终端在两条线各留了记录
- ● 各自都认为自己报的是真实需求
- ● 汇总时才凭空多出一截
重复的另一种形式更隐蔽:同一个客户在同一个渠道内部也被记了两次。比如一次是按项目登记,另一次是按日常采购登记,两条记录都没有错,只是分属不同的动作路径。如果系统里没有把这两条记录归到同一个客户下,重复就会在渠道内部先发生一轮,再往上传递。
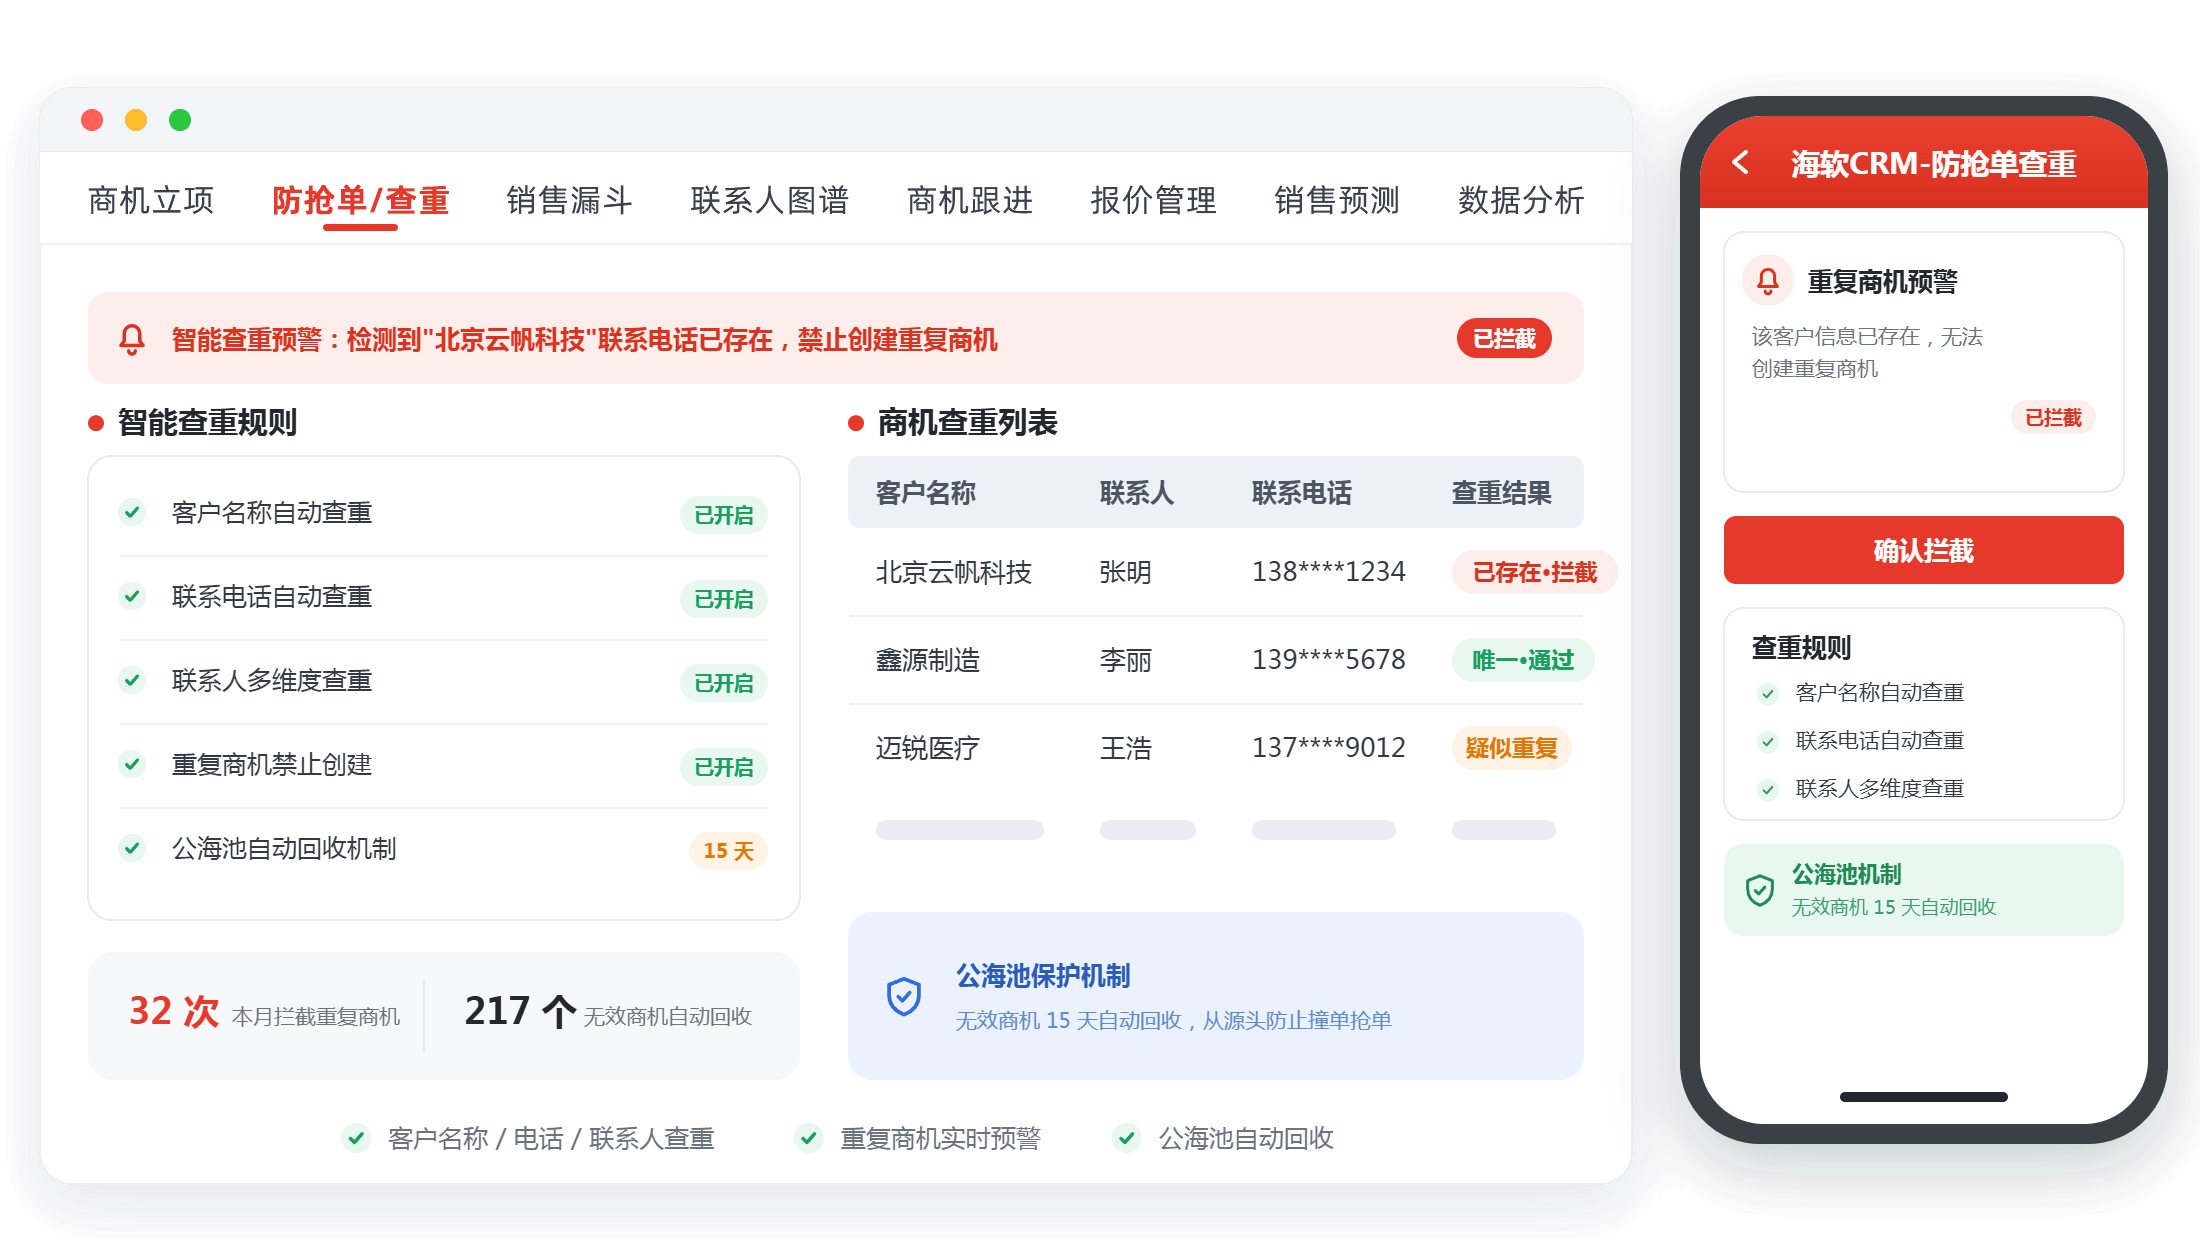
图2:同一份需求被算几次,是最常见的虚高
三、第二处:型号与口径在传递中错位
这一处失真的另一个来源是层级口径。同一个型号在区域这一级是按客户统计的,到了大区这一级是按渠道统计的。两种口径下的数量含义不同。如果汇总时不做换算,直接相加,就会得到一个既不是按客户算、也不是按渠道算的数字,看上去完整,其实没有任何一种用法能用上。
第二处失真藏在名字里。
同一个器件,客户习惯用一个叫法,厂商内部的物料编码是另一套,不同区域的分销环节可能还有各自的口头简称。如果这些叫法在系统里没有归到一个物料上。那么同一件事就会被拆成好几件事。
错位的后果是双向的。拆开之后,每个名字下的数量都不大,看上去不构成一个值得排产的量,于是被忽略;而实际上,加在一起已经足够影响排产。反过来,如果归并的规则过宽,把两个确实不同的规格合成了一个,又会造成另一种误导。
- ● 同名不同物,会让真实需求被拆散
- ● 一物多名的处理,靠的是主数据而不是人工记忆
- ● 归并规则过宽过窄,都会误导判断
错位还有一个时间维度。同一个器件的叫法会随着产品迭代变化,旧叫法不会立刻消失,新叫法又会陆续出现,两种叫法在系统里并存一段时间是常态。说穿了,这段时间里如果没有明确的对应关系,同一件东西就会被前后两次统计各自算一遍,而且这类偏差往往集中在型号交替的节点上。正好是最需要看清的时候。
图3:填过的每一版,都能被翻出来对
四、第三处:填报时的自我加码
这一处失真的一个特点是它随环境变化。当供应紧张、交期拉长的时候,加码的幅度会明显变大,因为交付风险上升了;当供应宽松的时候,加码会自然收窄。所以同一个渠道在不同时期的数字水分并不一样,用固定的系数去还原。效果通常不理想。
第三处失真最接近人们印象中的那个原因,但它其实是理性的。
填报的一方要考虑自己的交付责任。报少了,万一需求上来而自己没有提前锁定资源,后果要自己承担;报多了,大不了就是被追问几句。在这种成本不对称的处境下,稍微加一点余量,几乎是一种必然的选择。
- ● 报少了风险自己扛,报多了责任摊薄
- ● 成本不对称,加码就是理性选择
- ● 靠讲道理纠正不了,只能靠机制对冲
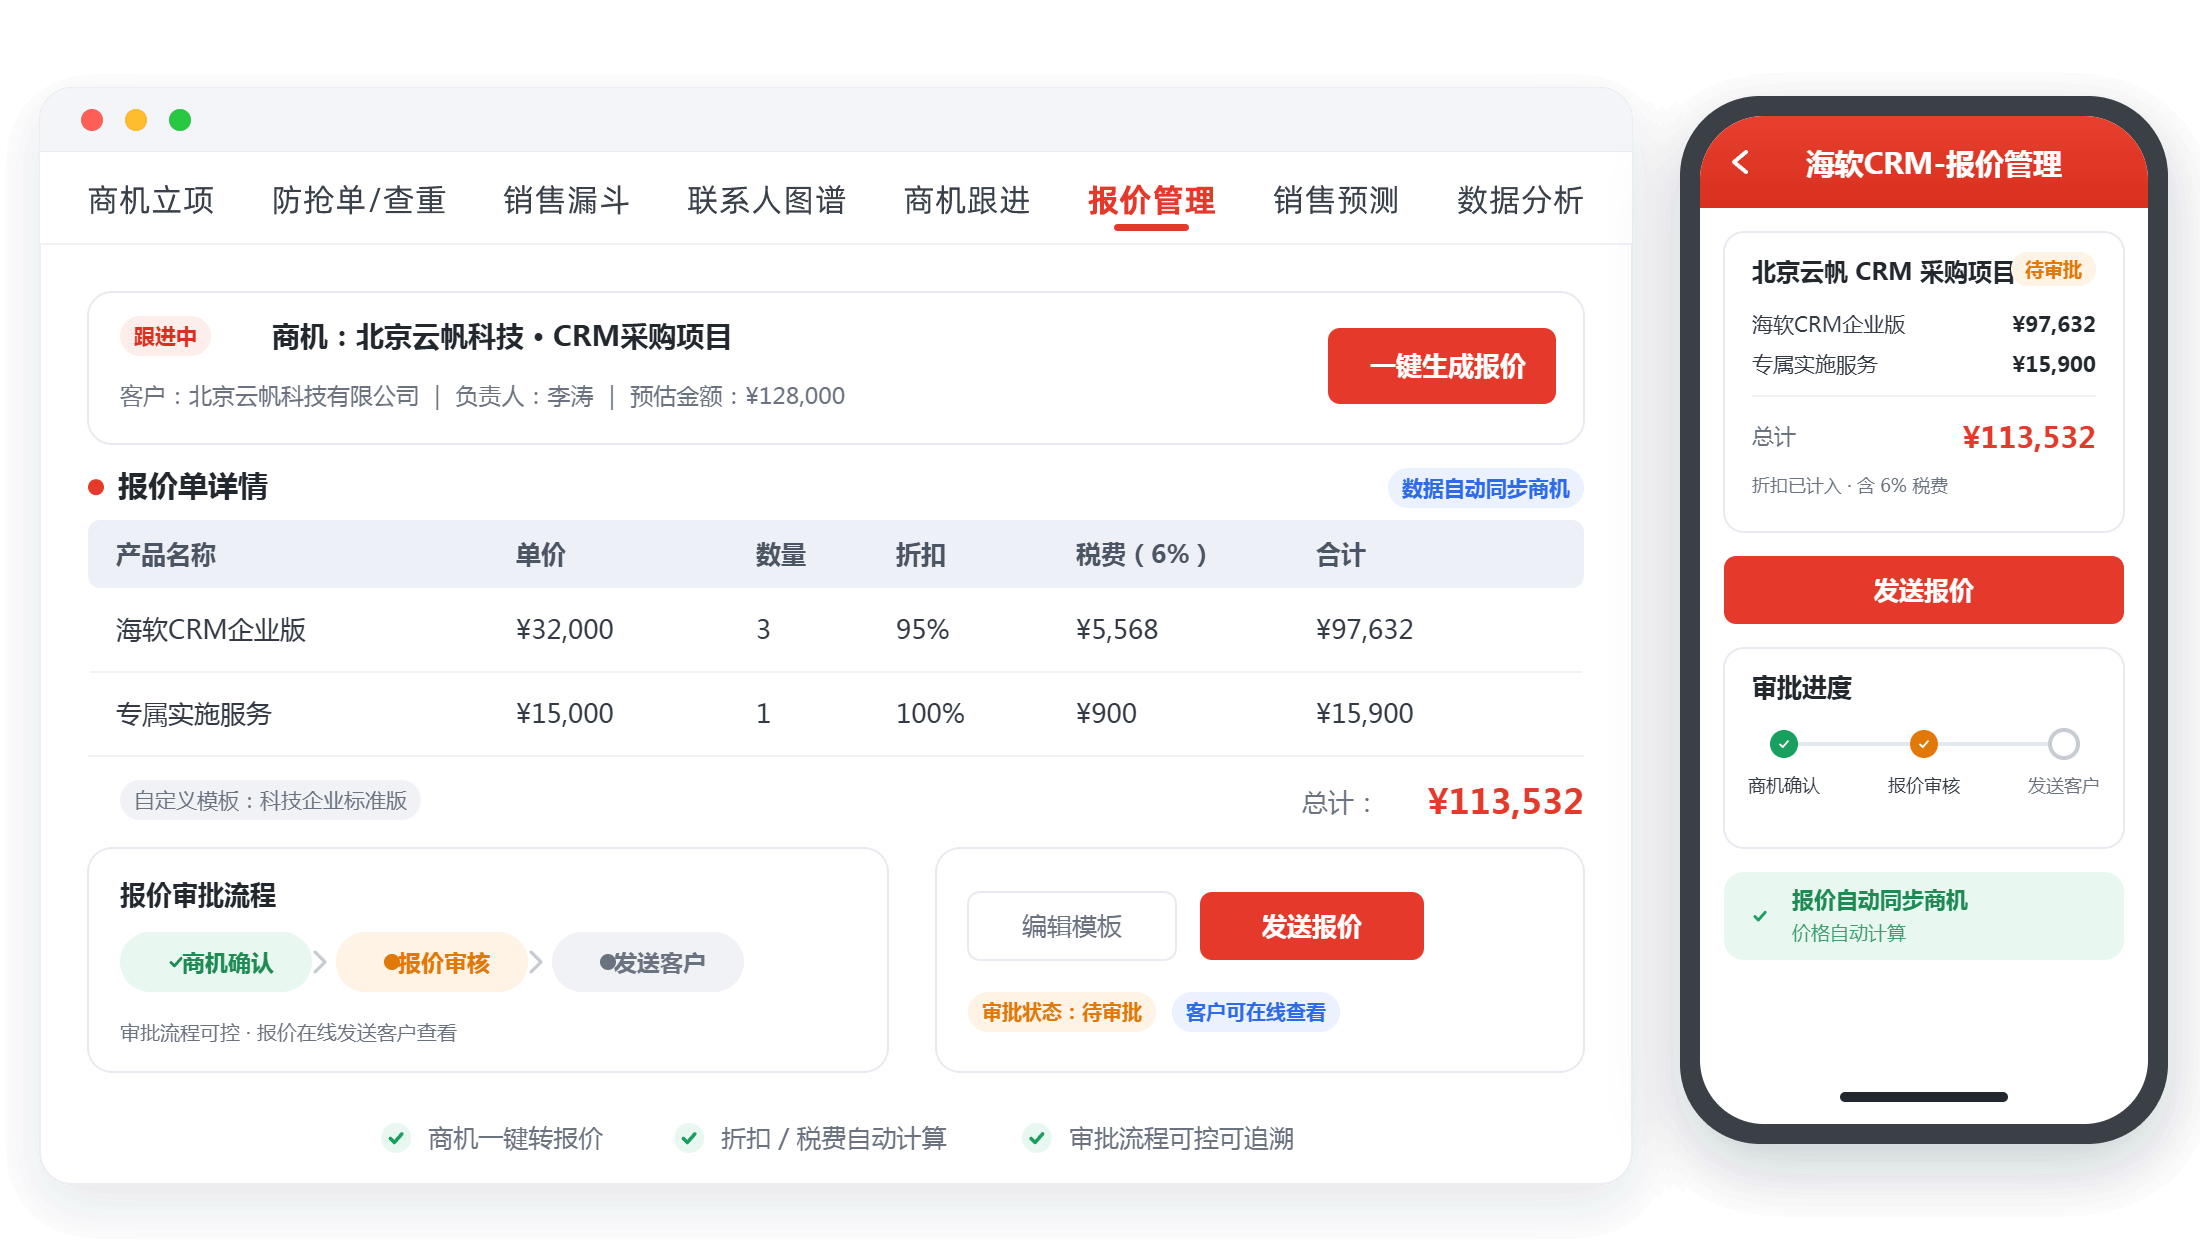
图4:报价的节奏,也反映着渠道的判断
五、三处失真的共同点
还有一层含义:既然是交接处出的问题,那么单独看任何一方的数据都是干净的。渠道看自己的记录,没有重复;原厂看自己的记录,也没有重复。问题只有在两边放到一起时才出现。这也解释了为什么内部自查往往查不出来。自查只能看到自己那一段。
把三处放在一起看,会发现它们有一个共同点:都不是在填报的那一刻产生的,而是在信息从一处流到另一处的过程中产生的。
重复来自两条路径之间没有打通,错位来自命名体系之间没有对齐。加码来自责任与风险之间的不对称。三处的共同点是,它们都发生在「交接」的环节,而交接的环节恰恰是最容易被系统忽略的地方。
- ● 重复是路径之间没打通
这三处失真还会互相诱发。命名不统一会造成重复,重复又会让某一方的数字显得偏高,偏高的一方为了保住份额会进一步加码。所以治理最好从命名和主数据入手,那里一通。后面两处也会跟着松一些。
- ● 错位是命名之间没对齐
把三处的顺序理清,还有一个实际好处:安排改进的先后时有依据。命名与主数据是基础,放在最前;登记环节的查重紧接着跟上;加码的对冲则要靠时间积累。往简单里说,不按这个顺序做,往往事倍功半。
- ● 加码是权责之间不对称
把三处失真分开之后,治理的动作也就分开了。第一处要在登记环节加提示和查重,第二处要在主数据上做归并。第三处要在长期对账中慢慢平衡。三件事的见效周期不同,前两件在一段时间内就能看到改善。第三件需要好几个期次才看得出来。混在一起推进,很容易因为第三件见效慢而以为整套办法没用。
这也解释了为什么单纯强调填报纪律收效有限。纪律只能作用于下游动作,而失真的主要来源在上游的结构。要治,就得在交接的地方补上记录与对照。让每一处偏差都能被指出来。
以海软CRM为例,它把客户、型号的主数据统一维护,把同一终端在两条线的记录归到同一个客户档案下,同时保留每一版填报的痕迹。三处失真里,前两处靠主数据和归并规则化解。第三处靠偏差的持续对照来对冲。
六、常见疑问集中回应
1、问:三处失真里,哪一处最难治?
答:第三处。前两处是结构问题,把主数据和路径打通就能改善;第三处是动机问题,只要责任与风险不对称,加码的冲动就会一直在,只能靠长期的对账来平衡。
2、问:重复计入能不能靠人工排查解决?
答:量小的时候可以,量一大就不行了。人工排查依赖记忆和责任心,换个岗位就断档。更稳的做法是让系统在登记时就提示「这个客户已有记录」。
3、问:型号叫法不统一,是不是要先把编码理清楚再上系统?
答:不必等到完全理清。可以先上线,把发现的同名不同物逐步归并,系统里的归并动作本身就是在理编码,比在表格里讨论更有效。
4、问:如果渠道不愿意被看到调整的痕迹怎么办?
答:要区分「看到调整」和「追究调整」。系统里呈现的是调整前后的版本,目的主要是让判断有参照。把用途讲清楚,抵触会小很多。
5、问:怎么判断三处失真有没有被治住?
答:看三件事:同一个客户能不能被认出来是同一个、同一个型号能不能被归到同一个物料上、同一份填报能不能看到前后两版。三件都能做到,失真的源头就基本被盖住了。